生成がほぼ無料になったとき、ボトルネックは検証になる
- エージェンティックAI
- 説明可能性
ある場面を想像してみてください。それは、すでに毎日のように起きています。
生成AIツールが40秒で30ページの文書を作成します。サプライヤー資料の要約、コンプライアンスレビュー、購買の推奨。翌日には、その文書を委員会、顧客、あるいは監査人の前で説明しなければなりません。
生成には1分もかかりませんでした。では、その結果を検証するのにどれだけの時間が必要でしょうか。1時間、ときには丸一日です。
生産はほぼ瞬時になりました。しかし信頼は、いまも人間の時間単価で支払われています。
このパラドックスは、企業AIがいま抱えている問題を端的に示しています。クラウド世界大手4社は2025年に4,000億ドル規模の投資を行い、2026年には7,000億ドル近くを投じると表明しています。その一方で、MITのレポートは2025年夏の時点で、生成AIのパイロット案件の95%がまだ測定可能なリターンを生んでいないと推計し、S&P Global Market Intelligenceは、調査対象企業の42%がAIイニシアチブの大半を断念しており、1年前の17%から増えていると指摘していました。
モデルの性能は、もはや主要な障害ではありません。情報へのアクセスもまた同様です。
問題は、生成の後に始まります。
AIは仕事を移動させた
言語モデルは、その構造上、確率的なものです。もっともらしい回答を生成し、多くの場合は正確ですが、ときに誤ります。しかも、事実の誤り、誤読された出典、見落とされた矛盾が、読み手に自ら知らせてくれることはありません。
そのため、結果が実際に意思決定に関わるとき、実務で責任を負う利用者が取る戦略は単純です。検証する、ということです。
しかも多くの場合、ほぼすべてを検証することになります。
つまり、仕事は消えたのではありません。移動したのです。
かつて担当者は、調べ、比較し、分析し、そして書き上げることに時間を費やしていました。いまでは、すでに生成された回答を点検しなければなりません。生成はプロセスの一部を劇的に加速しますが、必ずしも全体を加速するわけではありません。
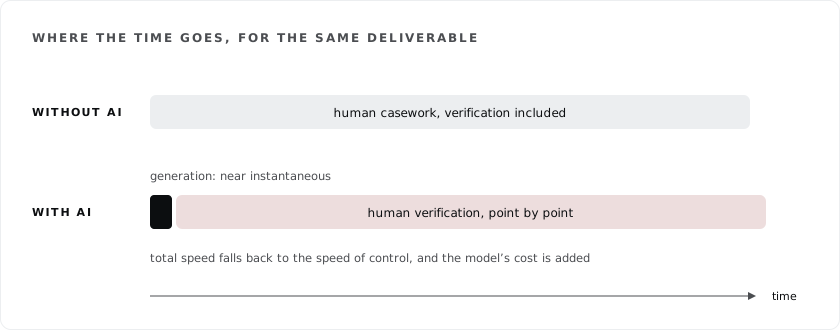
この移動が一層重大なのは、人間による点検が、すでに飽和した環境の中で行われるからです。31か国31,000人のデータをもとに2025年6月に公開されたマイクロソフトの労働時間に関する調査は、1人あたり1日平均117通のメールと153件のインスタントメッセージ、そして2分ごとの割り込みを数えています。
このような状況では、より多くの情報を生み出しても、意思決定の能力が機械的に高まるわけではありません。ボトルネックが、その情報を選別し、検証し、引き受ける立場の人へと移るだけのこともあります。
誤りは、自らの存在を知らせない
このコストを抜き取り検査で減らすことも考えられます。結果の一部だけを検証し、残りは信頼するという方法です。
この戦略は、リスクが小さい場合には機能します。メールの下書きや最初の調査であれば、時折の誤りは許容できることが多いでしょう。
しかし、出力が意思決定に関わるとなると、この方法を正当化するのははるかに難しくなります。
12件の回答のうち1件に重大な誤りが含まれているとしましょう。見た目には、その1件を残りの11件と区別する手がかりは必ずしもありません。まさにそこが問題です。誤りが即座に特定できるのであれば、そもそも検証は必要ないのです。
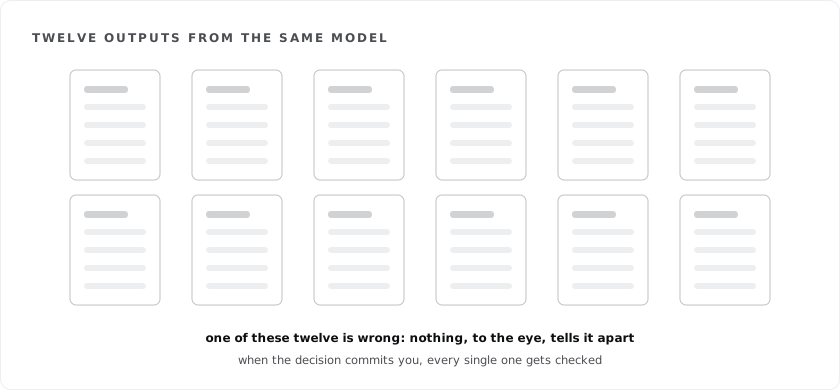
したがって、重要な業務の場面では、自動生成された出力は、出典と結び付けられ、理解され、異議を唱えられ、修正され得るものであって初めて価値を持ちます。
マネージャーは、なぜその推奨がなされたのかを問えなければなりません。監査人は、それを裏付ける根拠をたどれなければなりません。新しい情報は、それ以前の履歴を消すことなく結論を変更できなければなりません。
規制の枠組みも、この要請を明文化し始めています。EUのAI規則第14条は、ハイリスクなシステムに対して実効的な人間による監視を義務付けています。
しかし規制は、より一般的な経済問題を明示しているにすぎません。最終的な意思決定の責任を人間が負い続ける限り、問われるのはAIに何が生成できるかだけではないのです。
AIの出力を信頼できる状態にするために、人間のコストがどれだけ必要かを知らなければなりません。
プロダクトは、もはや回答だけではない
企業が買いたいのは、自社データと会話できることではありません。課題が解決されることです。
この区別は、AIが単なる生産性向上ツールを超え、仕事そのものに直接取り組むようになるにつれて重要になります。セコイア・キャピタルが2026年3月に公開した「Services: The New Software」の中で、Julien Bekは、ソフトウェアに1ドルが投じられるごとに約6ドルがサービスに支出されていると指摘しています。
言い換えれば、ソフトウェア市場が主に表しているのは、仕事を遂行するために使われる道具です。サービス市場が表しているのは、仕事そのものです。
AIはいま、後者に取り組み始めています。
しかし、仕事の成果物を生み出すだけでは足りません。自動化された成果物が業務プロセスに実際に組み込まれるためには、人間がそれをやり直すことなく使えなければならないのです。
価値は、徐々にそこへ移りつつあります。
コンテンツの生成はコモディティ化しつつあります。文書を要約し、分析を書き、推奨を提案できるモデルは、ますます増えています。
希少であり続けるのは、ある結論がなぜ信頼に足るのか、何に基づいているのか、何がそれと矛盾しているのか、そして決定にはまだ何が欠けているのかを知る能力です。
したがって、次の課題は単により多く生成することではありません。
信頼を、生成と同じようにスケールさせることです。
意思決定そのものではなく、意思決定を支える
Cercleの出発点は、意図的に単純なものにしています。意思決定の責任は、人間の意思決定者が負い続けるということです。
私たちの役割は、その判断を置き換えることではありません。判断を正しく行使するために必要なコストを引き下げることです。
対象とする意思決定の種類ごとに、まず、専門家が判断を下すために合理的に揃えておくべきものを定義します。必要な情報源、業務上の判断基準、矛盾する要素、許容できる不確実性の水準、点検のルールです。
そのうえで、私たちのエージェントが事案ごとに意思決定資料を構築します。
その原理は、意思決定者に諮る前に資料一式を整える部門の働きに近いものです。権限はあくまで人間にあります。システムは、その裁定に必要な材料を準備します。
意思決定資料はまず結論を示し、適切な場合には推奨も示します。続いて、各要素が出典と日付を保持したままの簡潔な証拠の連鎖を提示します。矛盾は黙って解消するのではなく明示し、欠けている情報を可視化し、確信度を見積もり、詳細は必要になったときにだけ展開できるようにします。
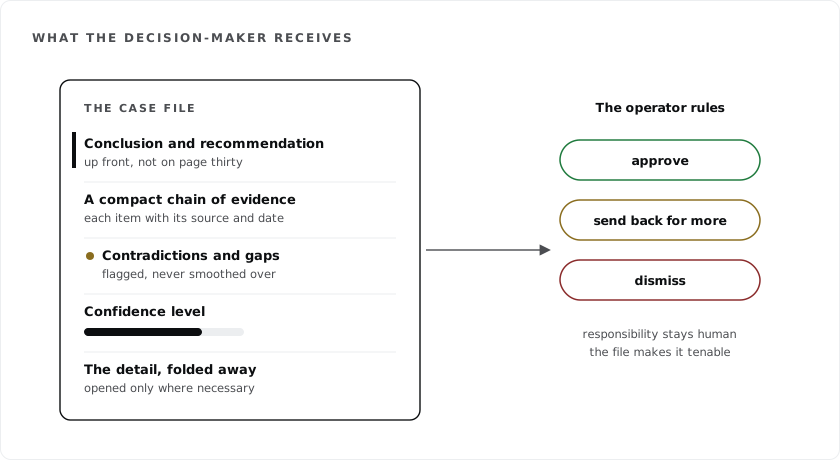
担当者はもはや、推論の全体を自ら再構築する必要はありません。それを検討し、必要なら異議を唱え、そして裁定します。承認するか、補完させるか、却下するかです。
その責任がなくなるわけではありません。
減るのは、責任を果たすために必要なコストです。
この区別は本質的です。目的は人間をループから外すことではなく、人間が合理的に監督できる情報の量と複雑さを大幅に引き上げることにあります。
毎分1,000ページを生成するAIも、それを検証する人間の能力が変わらないままでは、さして役に立ちません。
説明可能な結果には、履歴を追えるメモリが必要
このような意思決定資料は、その時点で確認できた最新の事実しか保持しない記憶からは作れません。
従来の情報システムは、一貫した状態を保つことを目指すのが通例です。対象ごとに一つの値を持ち、新しい情報が届けば更新します。二つの情報源が食い違えば、たいていは一方が他方を置き換えるか、調整済みの値が採用されます。
このロジックは、システムの現在の状態を知る必要がある場合には適しています。
しかし、結論がどのように得られたのかを説明する必要がある場合には、あまり適していません。
現実の情報環境が完全に整合していることは、めったにありません。情報源は古くなります。信頼できる二者が矛盾することもあります。昨日は正しかったデータが今日は誤りになります。合理的な仮説が新しい証拠によって覆されます。
意思決定を説明できるようにするには、システムは最終状態以上のものを保持しなければなりません。
その履歴を保持しなければならないのです。
そのために私たちは、知識を確定した事実としてではなく、信念として表現します。出典と日付を持ち、改訂可能で、確信度が紐付いた信念です。
手元の材料では決着がつかない限り、矛盾する二つの主張は併存できます。どの変化も、それを引き起こした証拠と結び付いたまま残ります。改変不可能で再生可能なイベントログにより、任意の時点のシステム状態を再構築し、どのように変化してきたのかを理解できます。
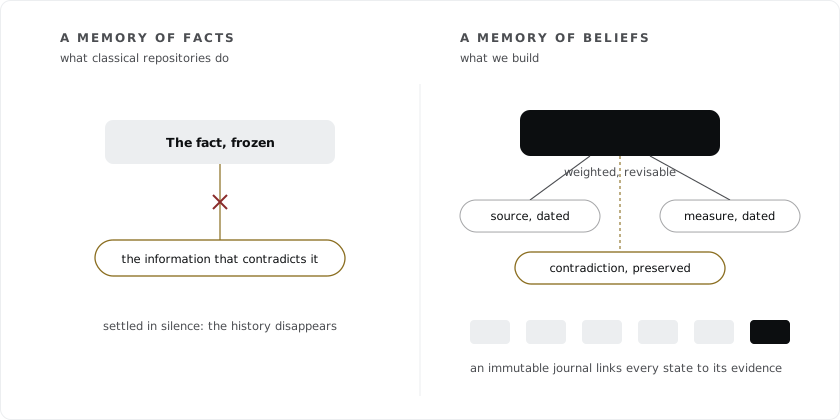
このアーキテクチャは、プロダクトに付け加えられた理論上の装飾ではありません。当初の推論の痕跡を失うことなく、結果を監査し、反論し、更新できるための必要条件なのです。
現在、この基盤の上で二つのプロトタイプが稼働しています。最初のユースケースは、戦略インテリジェンスと、特に部品表(BOM)を起点とするサプライチェーンの監視です。
信頼が最も価値を持つ領域から始める
当然ながら、この要請の経済的な価値は、どこでも同じというわけではありません。
最初のアイデアを出す、会議を要約する、文書を起草するといった用途であれば、単にもっともらしい回答で足りることもあります。
そこで私たちは、意思決定が実際に責任を伴う領域から始めます。防衛、原子力、規制下の金融、行政機関、そしてより一般的には、下した結論を数週間後、数年後にも正当化できなければならない環境です。
これらの分野では、点検のコストはすでに大きなものです。誤りは特定可能な責任を生じさせます。トレーサビリティ、コンプライアンス、監査対応力は付随的な機能ではなく、購入されるプロダクトの一部なのです。
こうした環境は、デジタル主権の観点でも厳格な設計を求めます。単なるローカルホスティングではなく、欧州域外の法的リスクにさらされずに運用できること、そして必要な場合にはローカルで実行されるモデルで動作できることです。
それに伴い得る性能面のトレードオフを、私たちは引き受けます。
Cercleの価値は、モデルのベンチマークで数ポイント上回ることにはありません。そのモデルの周囲に築かれる信頼のレイヤー、すなわち記憶、証拠、矛盾、監査可能性、そして人間による監督にあります。
信頼に至るまでの時間を測る
最後に、単純な問いが残ります。これらすべてが機能しているかどうかを、どうやって知るのかという問いです。
生成されたトークン数を測ることではありません。レポート作成の所要時間を計ることでもありません。エージェントが華々しいデモを単独でこなせると示すことでもありません。
測るべきなのは、人間がその結果を理解し、責任を持てる状態になるまでの時間です。
私たちが追跡しているのは、次の単純な比率です。
意思決定資料のレビュー時間 / 同じ検討を手作業で行うために必要な時間。
この比率が1を明確に下回らない限り、AIはプロセスの生産性を実際には高めていません。仕事を移動させただけです。
私たちが目指すのはその逆です。数秒で生成された結果を、人間が数分で理解し、検証し、証拠とともに引き受けられるようにすることです。
生成能力は、すでに十分にスケールしています。
次にスケールさせるべきなのは、信頼です。
出典
- CNBC、「Tech AI spending may approach $700 billion this year, but the blow to cash raises red flags」、2026年2月6日。
- MIT NANDA、「The GenAI Divide: State of AI in Business 2025」、2025年7月。
- S&P Global Market Intelligence(CIO Dive掲載)、「AI project failure rates are on the rise」、2025年。
- Microsoft WorkLab、「Breaking down the infinite workday」、2025年6月。
- Julien Bek、Sequoia Capital、「Services: The New Software」、2026年3月。
- 欧州AI規則(EU)2024/1689、第14条(人間による監視)、2026年8月よりハイリスクシステムに適用。